RAG einfach erklärt heißt: Bevor ein Sprachmodell antwortet, sucht die Software die passenden Stellen in euren Dokumenten heraus. Das Modell bekommt nur diese Stellen zusammen mit der Frage und stützt seine Antwort darauf. So arbeitet die KI mit eurem Firmenwissen, ohne dass ihr ganze Handbücher in den Prompt kopiert.
Retrieval Augmented Generation (RAG) ist ein Verfahren, bei dem ein Sprachmodell zu jeder Frage passende Abschnitte aus einer Dokumentensammlung abruft und seine Antwort darauf stützt. Den Begriff hat eine Forschungsgruppe um Patrick Lewis im Jahr 2020 geprägt (Lewis u. a. 2020).
Warum ein Sprachmodell euer Firmenwissen nicht kennt
Ein Sprachmodell weiß nur, was es im Training gelernt hat. Eure Preislisten, euer Personalhandbuch und eure Wartungsanleitungen gehören nicht dazu. Fragt eine neue Kollegin nach der Urlaubsregelung, kann das Modell bestenfalls raten.
Der naheliegende Ausweg ist, alle Dokumente in den Prompt zu kopieren. Bei wenigen Seiten funktioniert das. Bei einem realistischen Umfang wird jede Anfrage teuer und langsam, und irgendwann passt der Text nicht mehr in das Kontextfenster des Modells. RAG löst das Problem, indem nur die wenigen relevanten Abschnitte an das Modell gehen.
So funktioniert Retrieval Augmented Generation
Das Prinzip besteht aus drei Schritten:
- Zerlegen. Die Software teilt jedes Dokument in Abschnitte auf, die sogenannten Chunks. Ein langes Handbuch ergibt viele Chunks.
- Umwandeln. Ein Embedding-Modell übersetzt jeden Abschnitt in einen Vektor. Das ist eine Zahlenfolge, die die Bedeutung des Textes abbildet.
- Suchen und antworten. Stellt jemand eine Frage, wandelt dasselbe Embedding-Modell auch die Frage in einen Vektor um. Die Software vergleicht ihn mit allen Abschnitten und gibt die besten Treffer zusammen mit der Frage an das Sprachmodell weiter.
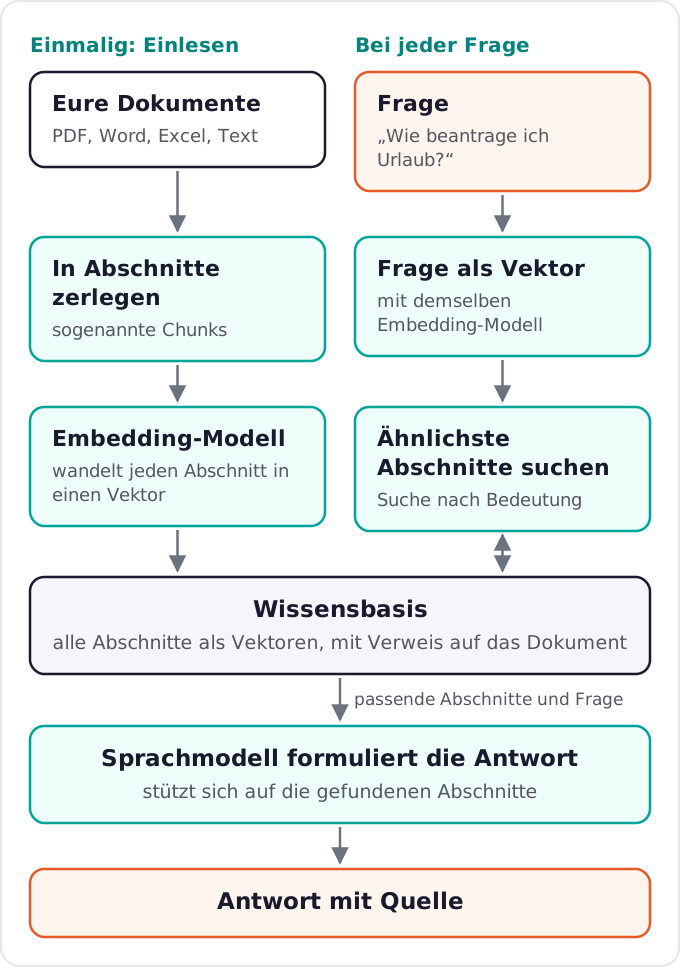
Die Suche arbeitet nach Bedeutung. Eine Anfrage zur „Urlaubsregelung“ findet deshalb auch ein Dokument mit dem Titel „Handbuch Jahresurlaub“, obwohl das Wort „Urlaubsregelung“ dort nirgends steht.
RAG, Fine-Tuning und Stichwortsuche im Vergleich
Neben RAG gibt es zwei Wege, die oft verwechselt werden. Die Tabelle zeigt die Unterschiede.
| RAG | Fine-Tuning | Stichwortsuche | |
|---|---|---|---|
| Was passiert | Passende Abschnitte werden zur Laufzeit gesucht und an das Modell übergeben | Das Modell wird mit eigenen Beispielen weitertrainiert | Dokumente werden nach exakten Wörtern durchsucht |
| Ergebnis | Formulierte Antwort aus euren Dokumenten | Ein angepasstes Modell, das Stil und Aufgaben besser trifft | Trefferliste, die ihr selbst lest |
| Neues Wissen aufnehmen | Dokument austauschen und neu einlesen | Erneut trainieren | Sofort, sobald das Dokument im Index liegt |
| Herkunft der Antwort | Treffer lassen sich bis zum Abschnitt zurückverfolgen | Nicht nachvollziehbar | Fundstelle ist sichtbar |
| Findet „Jahresurlaub“ bei der Frage nach „Urlaubsregelung“ | Ja, die Suche arbeitet nach Bedeutung | Keine Suche, das Modell antwortet aus dem Training | Nein, nur exakte Wörter |
Für Firmenwissen, das sich laufend ändert, ist RAG meist der passende Weg. Deshalb steht es auch im Mittelpunkt, wenn ihr KI im Unternehmen einführt. Fine-Tuning lohnt sich eher, wenn ein Modell ein bestimmtes Format oder einen Ton dauerhaft lernen soll. Das schnell.digital AI Kit nutzt für Firmenwissen RAG.
Wie RAG im AI Kit umgesetzt ist
Im AI Kit heißt RAG schlicht Wissen. Ihr legt eine Wissensbasis an, wählt ein Embedding-Modell und eine Quelle. Als Quellen stehen der Datei-Upload, statischer Text, Webinhalte, Datenbanken und, wenn die Installation es erlaubt, Ordner auf dem eigenen Server zur Verfügung. Die Zerlegung in Abschnitte übernimmt die Plattform beim Einlesen selbst.
Agenten und KI-Aktionen in Workflows durchsuchen verbundene Wissensbasen und antworten mit den Treffern. Ein eigener Schritt „Wissensabfrage“ sucht, ohne ein Modell aufzurufen. Ein späterer Schritt formuliert daraus die Antwort. Diese Trennung hat einen Vorteil: In der Ansicht der Läufe seht ihr genau, was gefunden wurde, und ihr könnt das Sprachmodell wechseln, ohne die Suche anzufassen. Die Treffer kommen mit Quellenangabe zurück.
Im Editor jeder Wissensbasis gibt es eine Testfunktion. Ihr gebt eine Frage ein und seht, welche Abschnitte zurückkommen. Nach diesem Prinzip arbeitet auch der KI-Onboarding-Assistent, der Fragen neuer Mitarbeitender aus euren Richtlinien beantwortet. Was ihr inhaltlich in eine Wissensbasis packt und wie ihr sie aufteilt, beschreibt der Artikel zur KI-Wissensdatenbank. Einen Überblick über alle Bausteine gibt die Seite Funktionen des AI Kit.
Das Embedding-Modell bewusst wählen
Im AI Kit gibt es zwei Arten von Modellen. Chat-Modelle formulieren Antworten. Embedding-Modelle wandeln Text in Vektoren für die Suche um. Jede Wissensbasis braucht ein Embedding-Modell, und diese Wahl solltet ihr am Anfang treffen.
Ein späterer Wechsel macht alle bereits eingelesenen Abschnitte ungültig. Die Wissensbasis muss dann vollständig neu aufgebaut werden, und das kostet so viel wie die erste Indexierung. Bewährt hat sich dafür eine feste Reihenfolge: neue Wissensbasis anlegen, Automationen umstellen, alte löschen. Wissensbasen, die ihr gemeinsam durchsuchen wollt, bekommen dasselbe Embedding-Modell.
Wer Dokumente gar nicht an externe Anbieter geben will, betreibt das Embedding-Modell selbst, zum Beispiel über Ollama auf einem eigenen GPU-Server. Was das an Hardware braucht, steht im Artikel zu lokaler KI ohne Cloud.
Typische Fehlerquellen bei KI mit eigenen Dokumenten
Die meisten Probleme mit RAG lassen sich auf wenige Ursachen zurückführen:
- Schlechte Suchtreffer. Falsche Antworten entstehen oft schon bei der Suche. Prüft zuerst die gefundenen Abschnitte und feilt erst danach am Prompt. Sind die Treffer themenfremd, liegt es am Embedding-Modell oder an der Zerlegung. Stimmen die Treffer und die Antwort trotzdem nicht, liegt es am Prompt oder am Sprachmodell.
- Ungenaue Suchanfrage. Die konkrete Frage eignet sich als Suchbegriff meist besser als der ganze Gesprächsverlauf.
- Zu viele Wissensbasen. Jede unpassende Wissensbasis an einem Agenten bringt in jeder Runde zusätzliches Rauschen und Kosten.
- Gemischte Themen. Je vielfältiger die Inhalte einer Wissensbasis, desto schneller sinkt die Suchqualität.
- Veraltete Dokumente. RAG findet auch die Preisliste von 2023, wenn sie noch im Bestand liegt.
Auch mit RAG kann ein Modell eine Stelle falsch verstehen oder eine Lücke mit einer Vermutung füllen. Lasst deshalb Antworten, die an Kunden gehen, von einem Menschen prüfen. Die gefundenen Abschnitte gehen außerdem unverändert an das Sprachmodell. Welche Dokumente ein externes Modell sehen darf, klärt ihr mit euren Datenschutzbeauftragten. Mehr dazu steht im Artikel ChatGPT und Co. datenschutzkonform nutzen.
Häufige Fragen
Was bedeutet RAG?
RAG steht für Retrieval Augmented Generation, auf Deutsch etwa „durch Abruf erweiterte Texterzeugung“. Ein Sprachmodell sucht vor der Antwort passende Abschnitte in euren Dokumenten und stützt sich darauf.
Wird bei RAG ein eigenes KI-Modell trainiert?
Nein, das Sprachmodell bleibt unverändert. Eure Dokumente werden nur durchsuchbar gemacht, und zu jeder Frage gehen die passenden Abschnitte an das Modell. Aktualisiert ihr ein Dokument, liest die Wissensbasis es neu ein.
Erfindet eine KI mit RAG keine Antworten mehr?
RAG stützt Antworten auf eure Unterlagen und macht ihre Herkunft prüfbar. Eine Garantie für richtige Antworten gibt es trotzdem nicht. Ein Mensch sollte Ergebnisse prüfen, bevor sie das Haus verlassen.
Welche Dokumente eignen sich für RAG?
Fast jeder Text eignet sich: Handbücher, FAQs, Richtlinien, Produktbeschreibungen oder frühere Angebote. Das AI Kit liest unter anderem PDF, Word (DOCX), Excel, CSV, HTML, Markdown und Text ein. Alte Word-Dateien im DOC-Format werden abgelehnt.
Kann RAG ganz ohne Cloud laufen?
Ja. Dafür läuft das AI Kit auf euren eigenen Servern, und Chat-Modell und Embedding-Modell betreibt ihr dort selbst, etwa über Ollama auf einem GPU-Server. Dann verlassen weder die Dokumente noch die Fragen euer Netzwerk.
Euer nächster Schritt
Wie eine Wissensbasis mit Testfunktion und Quellenangaben in der Praxis aussieht, zeigen wir euch in einer Demo des AI Kit. Die Demo vereinbaren wir mit euch auf Anfrage.
Quellen
- Patrick Lewis u. a.: „Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks“, Konferenz NeurIPS, 2020