ChatGPT im Unternehmen datenschutzkonform zu nutzen gelingt, wenn ihr für jeden Arbeitsschritt wisst, wohin die Daten gehen. Personenbezogene Daten und Geschäftsgeheimnisse gehören nur zu Anbietern, mit denen euer Unternehmen einen Vertrag über die Verarbeitung hat. Dazu sendet ihr nur die nötigen Angaben und ersetzt Namen und Kontaktdaten vor dem Modellaufruf durch Platzhalter.
Dieser Artikel beschreibt die technische und organisatorische Umsetzung. Er gehört zur Reihe darüber, wie ihr KI im Unternehmen einführt. Die rechtliche Bewertung für euren Fall trefft ihr mit euren Datenschutzbeauftragten oder eurer Rechtsberatung.
Warum Datenschutz bei KI eine Frage der Datenwege ist
Unter den Unternehmen, die KI nutzen, nennen 66 % den Datenschutz als Hemmnis (Bitkom 2026). Oft steckt dahinter eine einfache Unsicherheit: Niemand weiß genau, wo eingegebene Daten landen und wie lange sie dort bleiben.
Ein typisches Beispiel: Eine Vertriebsmitarbeiterin kopiert eine Kundenmail mit Namen, Telefonnummer und Preiswunsch in ihr privates ChatGPT-Konto. Damit liegen Kundendaten bei einem Anbieter, mit dem euer Unternehmen keinen Vertrag hat. Fachleute sprechen dann von Schatten-KI, die meist ohne böse Absicht entsteht.
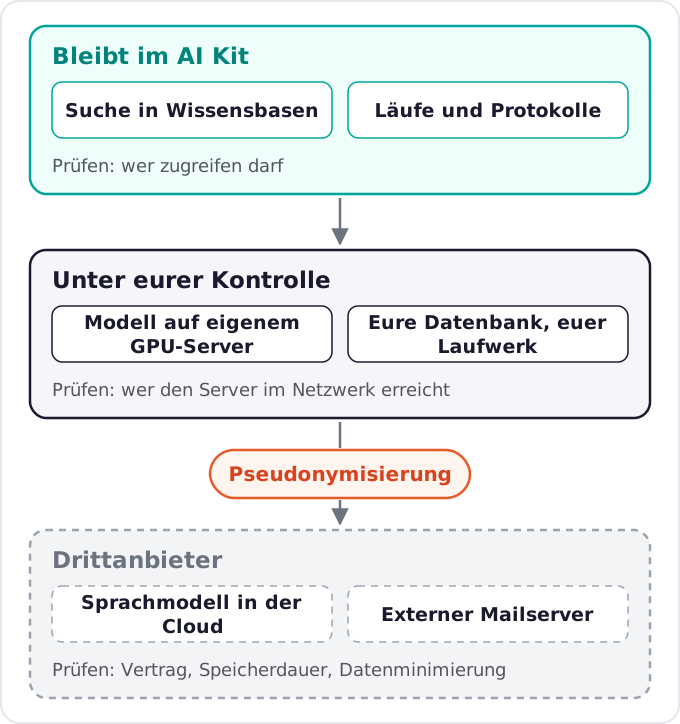
Hilfreich ist eine Leitfrage für jeden Schritt eines KI-Ablaufs. Bleiben die Daten im System, gehen sie in ein System unter eurer Kontrolle oder erreichen sie einen Drittanbieter? Die meisten Datenschutzfragen entstehen bei der dritten Möglichkeit.
| Schritt | Wohin die Daten gehen | Was ihr prüft |
|---|---|---|
| Suche in einer eigenen Wissensbasis | Sie bleiben im System | Wer auf die Wissensbasis zugreifen kann |
| Sprachmodell auf einem eigenen GPU-Server | Sie bleiben in eurem Haus | Wer den Server im Netzwerk erreicht |
| Abfrage eurer Datenbank, Ablage auf eurem Laufwerk | System unter eurer Kontrolle | Rechte und Aufbewahrung |
| Sprachmodell eines Cloud-Anbieters | Drittanbieter | Vertrag, Speicherdauer, Pseudonymisierung |
| E-Mail über einen externen Mailserver | Wie bei einem Drittanbieter | Empfänger und Inhalt |
Welche Daten als sensibel gelten
Was als sensibel gilt, hängt von eurer Branche und euren Vorgaben ab. Eine praktische Grundlage bilden vier Gruppen:
- Personenbezogene Daten: Namen, E-Mail-Adressen, Telefonnummern, Anschriften, Personal- und Kundennummern
- Gesundheits-, Finanz- und Rechtsdaten: Sie sind fast immer sensibel.
- Interne Geschäftsdaten: Kalkulationen, Strategiepapiere und Details zu unveröffentlichten Produkten
- Zugangsdaten: Passwörter, API-Schlüssel und Tokens sind ausnahmslos sensibel.
Schreibt für jeden KI-Ablauf einen Satz in die Beschreibung, etwa: „Dieser Ablauf verarbeitet Kundendaten. Sensibel: ja.“ So sieht jede Person, die den Ablauf später pflegt, sofort, worauf sie achten muss.
ChatGPT und DSGVO: was der Vertrag mit dem Modellanbieter regelt
In einer KI-Plattform wie dem AI Kit bindet ihr ChatGPT und andere Sprachmodelle über die Programmierschnittstelle des Anbieters an. Bring your own Key bedeutet, dass ihr ein Sprachmodell mit eurem eigenen API-Schlüssel nutzt und direkt mit dem Anbieter abrechnet. Das Vertragsverhältnis besteht dann zwischen euch und dem Modellanbieter.
Wie lange der Anbieter eure Anfragen speichert, hängt von diesem Vertrag ab. Lest ihn genau und verlasst euch nicht auf Annahmen. Im AI Kit liegen die API-Schlüssel verschlüsselt im jeweiligen Arbeitsbereich. Nach dem Speichern lassen sie sich ersetzen, aber nicht mehr auslesen.
Das AI Kit selbst läuft in der Cloud-Variante in einem Rechenzentrum in Deutschland, in der Inhouse-Variante auf euren eigenen Servern. Ein Auftragsverarbeitungsvertrag ist inklusive. Welches Modell eure Daten verarbeitet, entscheidet ihr selbst. Für besonders sensible Abläufe kann das ein lokales Sprachmodell auf einem eigenen GPU-Server sein.
Ein eigener Server ist allerdings nicht automatisch sicher. Kann ihn jeder im Unternehmen erreichen, ist er nicht vertraulicher als ein externer Dienst.
Pseudonymisierung: personenbezogene Daten vor dem Modell verbergen
Pseudonymisierung ist ein Verfahren, bei dem identifizierende Angaben vor der Verarbeitung durch Platzhalter ersetzt und danach wieder eingesetzt werden. Das externe Sprachmodell bekommt dann zum Beispiel den Platzhalter „#Name 01#“ zu sehen. In der fertigen Antwort stehen wieder die echten Werte.
Im AI Kit gibt es dafür zwei Wege. In Workflows baut ihr eine Kette aus Anonymisierer, KI-Aktion und Deanonymisierer. Bei Agenten genügt ein Schalter, dann maskiert die Plattform jede neue Nachricht und setzt in der Antwort die echten Werte wieder ein. Standardmäßig ersetzt sie Namen, E-Mail-Adressen, Telefonnummern und Postadressen. Eigene Muster beschreibt ihr in einem Satz, etwa: „Jedes Aktenzeichen der Form AZ- mit folgenden Ziffern maskieren.“
Grenzen der Pseudonymisierung
Die Pseudonymisierung senkt das Risiko deutlich. Diese Grenzen solltet ihr trotzdem kennen:
- Die Erkennung arbeitet statistisch. Ein KI-Modell sucht die Angaben und übersieht gelegentlich eine. Testet deshalb mit realistischen Daten und macht Stichproben.
- Das Pseudonymisierungsmodell sieht den Klartext. Betreibt dieses Modell deshalb selbst, zum Beispiel auf einem eigenen GPU-Server.
- Inhalte aus Wissensbasen werden nicht maskiert. Bei Agenten wird nur die Suchanfrage maskiert. Stehen personenbezogene Daten in den Dokumenten selbst, erreichen sie das Modell.
- Die Suche trifft unter Umständen schlechter. Fragt jemand nach einer Kundin mit Namen, sucht der Agent nach dem Platzhalter und findet Dokumente mit dem echten Namen nicht.
Verlangt eine Vorschrift, dass gar keine personenbezogenen Daten übermittelt werden, verlasst euch nicht allein auf die Pseudonymisierung. Das letzte Wort haben dann der Vertrag mit dem Anbieter, seine Nutzungsbedingungen und eure Datenschutzbeauftragten.
KI und personenbezogene Daten: weniger senden, kürzer aufbewahren
Den wirksamsten Schutz bietet die Datenminimierung. Sendet an ein externes Modell nur die Felder, die der Schritt wirklich braucht. Für die Einordnung einer Anfrage reicht meist der Text des Anliegens, den vollständigen Kundendatensatz braucht das Modell dafür nicht.
Diese Muster solltet ihr vermeiden:
- Vollständige Datensätze ohne Pseudonymisierung an ein externes Modell schicken. Die Daten liegen danach in den Protokollen des Anbieters.
- Zur Fehlersuche einen KI-Schritt einbauen, der alle Zwischenergebnisse eines Laufs an das Modell gibt.
- Kundendaten ohne Zugriffskonzept in eine Wissensbasis legen. Jeder Agent, der mit dieser Wissensbasis verbunden ist, kann sie durchsuchen.
Auch die Aufbewahrung zählt. Das AI Kit räumt beendete Workflow-Läufe standardmäßig nach 30 Tagen auf und löscht Gespräche mit Agenten nach 60 Tagen ohne Aktivität. Für sensible Abläufe lassen sich beide Fristen verkürzen. Öffnet außerdem regelmäßig einige Läufe und prüft, was tatsächlich an das Modell gegangen ist.
Beschränkt zuletzt, wer Abläufe bearbeiten darf. Wie Rollen, Freigaben und Protokolle zusammenspielen, beschreibt der Artikel KI-Prozesse kontrollierbar machen. Einen Überblick über Betrieb, Rollen und Pseudonymisierung gibt die Funktionsübersicht des AI Kit.
Häufige Fragen
Dürfen wir ChatGPT mit Kundendaten nutzen?
Das hängt vom Vertrag mit dem Anbieter, vom Zweck und von der Art der Daten ab. Ohne Vertrag über die Verarbeitung gehören Kundendaten nicht in das Werkzeug, private Konten scheiden damit aus. Besteht ein Vertrag, senkt ihr das Risiko mit Datenminimierung und Pseudonymisierung. Die Bewertung trefft ihr mit euren Datenschutzbeauftragten.
Werden unsere Daten zum Training von KI-Modellen genutzt?
Das hängt vom Modellanbieter ab. Ob er eure Anfragen speichert oder für Training nutzt, regelt euer Vertrag mit ihm. Lest diesen Vertrag deshalb vor dem Start. Wer das sicher ausschließen will, betreibt die Modelle selbst.
Reicht Pseudonymisierung für den Datenschutz?
Nein. Sie ist eine wichtige Schutzschicht, Verträge und Zugriffsrechte braucht ihr trotzdem. Die Erkennung arbeitet statistisch, und Inhalte aus Wissensbasen werden nicht maskiert. Bei hochsensiblen Daten kombiniert ihr sie am besten mit einem selbst betriebenen Modell.
Wie lange speichert das AI Kit Gesprächsverläufe?
Gespräche mit Agenten werden standardmäßig nach 60 Tagen ohne Aktivität gelöscht, zusammen mit ihren Dateien. Beendete Workflow-Läufe räumt die Plattform nach 30 Tagen auf. Beide Fristen lassen sich für eure Installation verkürzen.
Euer nächster Schritt
Im kostenlosen Erstgespräch schauen wir gemeinsam auf euren ersten KI-Ablauf. Wir klären, welche Daten er braucht, welcher Datenweg passt und welche Fragen ihr mit euren Datenschutzbeauftragten besprechen solltet.
Quellen
- Bitkom: Presseinformation „Erstmals nutzt die Mehrheit der Unternehmen KI“, 14.09.2026, und Präsentation „KI in der deutschen Wirtschaft: Status quo und Ausblick“, 2026. Befragt wurden 603 Unternehmen ab 20 Beschäftigten.