Lokale KI im Unternehmen lohnt sich vor allem bei strengen Vorgaben zur Datenhaltung und in Umgebungen ohne Internetzugang. Plattform und Sprachmodelle laufen dann auf euren eigenen Servern, die Modelle auf einer Grafikkarte (GPU), und keine Daten verlassen euer Netzwerk. Für viele Mittelständler ist ein Mischbetrieb der realistische Weg: Sensible Schritte laufen lokal, schwierige Aufgaben übernimmt ein externes Modell.
Lokale KI, oft auch On-Premise-KI genannt, bedeutet: Die KI-Anwendung und das Sprachmodell laufen auf Servern im eigenen Haus, das Sprachmodell auf einer GPU. Das Thema ist gefragt, denn 66 % der Unternehmen, die KI nutzen, nennen den Datenschutz als Hemmnis (Bitkom 2026).
Drei Betriebsarten: Cloud, Inhouse und ganz ohne Internet
Die Frage nach dem Betrieb klärt ihr früh, wenn ihr KI im Unternehmen einführt. Das schnell.digital AI Kit gibt es in drei Betriebsarten. Für eure Mitarbeitenden sieht die Bedienung in allen gleich aus.
- Cloud. schnell.digital betreibt das AI Kit in einem Rechenzentrum in Deutschland. Updates, Monitoring und Support sind in der Lizenz enthalten. Die Sprachmodelle bindet ihr über euren eigenen API-Key bei einem Anbieter an.
- Inhouse. Das AI Kit läuft als Docker-Container auf euren eigenen Servern. Für das AI Kit selbst empfehlen wir eine virtuelle Maschine mit 8 CPU-Kernen und 16 GB RAM. Die Modelle können extern sein oder lokal über Ollama auf einem GPU-Server laufen.
- Ohne Internet. Die Inhouse-Variante läuft auch in einem abgeschotteten Netz. Externe KI-Anbieter fallen dann weg, alle Modelle laufen über Ollama auf GPU-Servern im eigenen Haus.
Die Lizenz kostet in der Cloud ab 349 € im Monat und Inhouse ab 990 € im Monat, jeweils bei 12 Monaten Laufzeit. Alle Pakete stehen auf der Seite AI Kit Preise.
Wann sich KI ohne Cloud lohnt
Eigener Betrieb lohnt sich vor allem in diesen Fällen:
- Vorgaben zu Datenhaltung oder Datenschutz schließen externe Anbieter aus.
- Ihr arbeitet in einer abgeschotteten Umgebung ohne Internetzugang.
- Ihr wollt feste monatliche Serverkosten, die nicht mit jeder Anfrage steigen.
- Ihr wollt neue Open-Source-Modelle schnell selbst ausprobieren.
Genauso klar sind die Gründe dagegen. Bei den schwierigsten Aufgaben liegen die führenden proprietären Modelle weiterhin vorn. Bei geringem Volumen, etwa einer Handvoll Anfragen am Tag, ist die Abrechnung je Token günstiger als eigene Hardware. Außerdem braucht ihr jemanden im Team, der Server betreiben kann. Wie ihr Hardware, Lizenz und Token gegeneinander rechnet, beschreibt der Artikel KI-Kosten planbar machen.
Welche GPU braucht ein LLM im eigenen Haus?
Lokale Sprachmodelle laufen auf einem Server mit Grafikkarte (GPU). Im AI Kit bindet ihr sie über Ollama an, eine freie Software, die Open-Source-Modelle auf eigenen Servern bereitstellt. Entscheidend für die Planung ist der Speicher der Grafikkarte, der sogenannte VRAM. Je größer ein Modell, desto mehr VRAM braucht es und desto besser sind in der Regel seine Ergebnisse.
Für die Planung teilen wir lokale Modelle in drei Größen ein:
| Modellgröße | GPU-Speicher (VRAM) | Typischer Einsatz |
|---|---|---|
| Klein | ab 16 GB | Pseudonymisieren, Kategorisieren, kurze Zusammenfassungen |
| Mittel | ab 48 GB | Texte analysieren, Antworten aus Wissensbasen, Entwürfe für Mails und Angebote |
| Groß | ab 80 GB, oft verteilt auf mehrere GPUs | Längere Texte, tiefgreifende Recherche, komplexe Schlussfolgerungen |
Die Werte sind unsere Richtwerte, Stand November 2026. Sie enthalten Reserve für längere Eingaben und mehrere gleichzeitige Anfragen. Die Embedding-Modelle für die Suche in euren Dokumenten laufen auf derselben GPU mit. Wie diese Suche funktioniert, beschreibt der Artikel RAG einfach erklärt.
Welche Modellgröße für welche Aufgabe?
Nicht jede Aufgabe braucht das größte Modell. Diese Übersicht hilft bei der Zuordnung:
| Aufgabe | Lokale Modellgröße | Einordnung |
|---|---|---|
| Pseudonymisierung von Daten | Klein | Sollte lokal laufen, weil das Modell den Klartext sieht |
| Analysieren und Kategorisieren von Texten | Klein bis Mittel | Gut lokal machbar, etwa Mails einem Thema zuordnen |
| Antworten aus der Wissensbasis | Mittel | Lokal machbar, Qualität vorher mit echten Fragen testen |
| Erarbeiten von Angeboten | Mittel bis Groß | Für Angebote mit vielen Positionen ein großes Modell |
| Erstellung längerer Texte | Groß | Lokal nur mit großen Modellen gut |
| Tiefgreifende Recherche | Groß | Ein externes Modell ist hier oft die bessere Wahl |
Für Agenten, mit denen eure Mitarbeitenden chatten, zählt die Antwortzeit. Fragen mehrere Personen gleichzeitig, plant lieber eine Stufe größer. Für die Modelle selbst plant ihr mindestens 100 GB schnellen Speicherplatz ein. Ein Modell, das eine Weile nicht genutzt wurde, wird aus dem Speicher der GPU entladen. Die erste Anfrage danach dauert deshalb länger.
Welche Modelle sich gerade eignen, ändert sich schnell. Prüft die Auswahl deshalb zum Zeitpunkt eurer Einführung. Einen Überblick über europäische Open-Source-Modelle gibt unser Artikel zu Mistral AI.
Mischbetrieb: das passende Modell je Schritt
Im AI Kit könnt ihr mehrere Modelle an einen Workspace anbinden. Jeder Schritt einer Automation kann ein anderes Modell nutzen, auch innerhalb desselben Ablaufs. Daraus ergibt sich ein Mischbetrieb, der für viele Unternehmen gut passt.
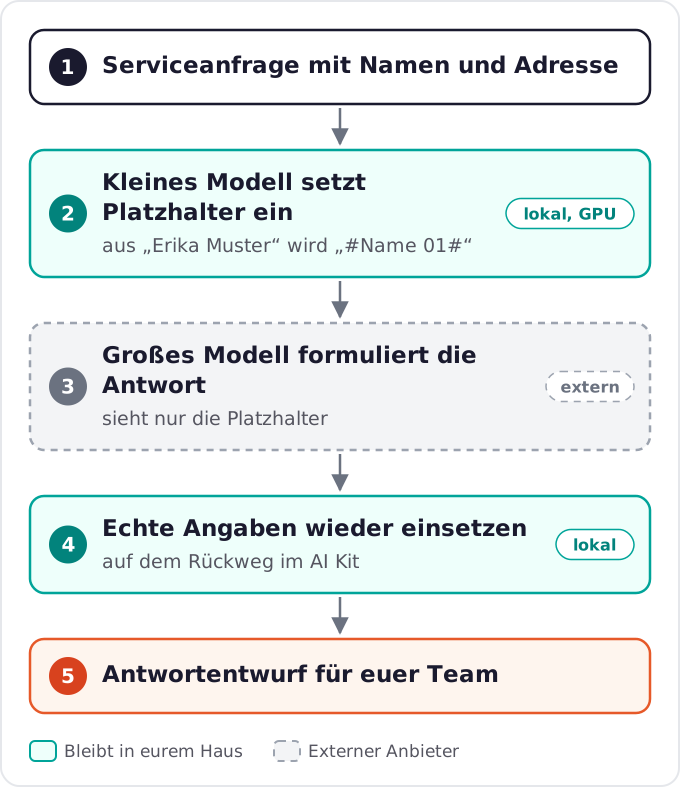
Ein Beispiel: Ein Anlagenbauer mit 120 Mitarbeitenden bearbeitet Serviceanfragen mit Kundennamen und Adressen. Ein kleines lokales Modell auf der eigenen GPU ersetzt diese Angaben zuerst durch Platzhalter. Danach formuliert ein leistungsfähiges externes Modell die Antwort, ohne die echten Namen zu sehen. Auf dem Rückweg setzt das AI Kit die echten Angaben wieder ein. Das Pseudonymisierungs-Modell sieht den Klartext und sollte deshalb selbst betrieben werden. Die Erkennung arbeitet statistisch und ist keine Garantie. Mehr dazu steht im Artikel ChatGPT und Co. datenschutzkonform nutzen.
Lokal heißt nicht automatisch sicher
Ein selbst betriebenes Modell auf einem Server, den jeder im Unternehmen erreicht, ist nicht vertraulicher als ein externes. Für den eigenen Betrieb gelten deshalb ein paar Regeln:
- Ollama nie direkt ins Internet stellen. Ollama hat keine eigene Anmeldung. Es gehört hinter eine Firewall und in ein privates Netz.
- Ausgehenden Verkehr begrenzen. Erlaubt nur die Ziele, die ihr tatsächlich nutzt. Laut Dokumentation sendet das AI Kit keine Inhalte eurer Workspaces an den Hersteller.
- Telemetrie abschalten, wenn nötig. Sie umfasst nur anonyme Angaben zu Version und Betriebszeit und lässt sich per Konfiguration abschalten.
- Anmeldung im eigenen Netz. Ohne Internet funktioniert die Anmeldung mit dem Firmenkonto über einen Anbieter im eigenen Netz, zum Beispiel Keycloak oder ADFS.
- Daten sichern und verschlüsseln. Das AI Kit hält alle Daten in zwei Verzeichnissen auf eurem Server. Sichert sie zusammen mit dem Schlüssel der Installation und verschlüsselt den Speicher des Servers.
Wer euer Netzwerk betreut, sollte diese Punkte vor dem Start prüfen. Welche Datenschutzpflichten für euren Einsatz gelten, klärt ihr mit euren Datenschutzbeauftragten. Hintergründe zur europäischen Perspektive gibt der Artikel Souveräne KI in der EU.
Häufige Fragen
Was bedeutet lokale KI?
Lokale KI heißt, dass KI-Anwendung und Sprachmodell auf Servern im eigenen Unternehmen laufen. Anfragen und Dokumente gehen dabei an keinen externen Anbieter.
Löst lokale KI alle Datenschutzfragen?
Nein. Der lokale Betrieb vereinfacht die Datenschutzlage, weil keine Daten an Dritte gehen. Zugriffsrechte, Löschfristen und der Zweck der Verarbeitung müssen trotzdem geregelt sein. Die Bewertung für euren Fall trefft ihr mit euren Datenschutzbeauftragten.
Welche Hardware brauchen wir für den Einstieg?
Für das AI Kit selbst empfehlen wir eine virtuelle Maschine mit 8 CPU-Kernen und 16 GB RAM. Für lokale Modelle kommt ein Server mit GPU dazu: für kleine Modelle ab 16 GB Grafikspeicher, für mittlere ab 48 GB.
Sind lokale Modelle so gut wie ChatGPT?
Bei den schwierigsten Aufgaben liegen die führenden proprietären Modelle vorn. Für Pseudonymisierung, kurze Zusammenfassungen und Sortieraufgaben reichen kleine lokale Modelle oft aus. Im Mischbetrieb nutzt ihr beides.
Kann das AI Kit ganz ohne Internet laufen?
Ja. Das Programmpaket lässt sich ohne Netzverbindung übertragen, die Modelle laufen über Ollama auf euren GPU-Servern. Für E-Mails braucht ihr einen internen Mailserver. Integrationen, für die ihr euch bei einem externen Dienst anmeldet, funktionieren ohne Internet nicht.
Euer nächster Schritt
Ob Cloud, Inhouse oder ein Mischbetrieb zu euren Vorgaben passt, besprechen wir im kostenlosen Erstgespräch. Bringt eure Anforderungen an Datenhaltung und eure vorhandene Server-Ausstattung mit.
Quellen
- Bitkom: Präsentation „KI in der deutschen Wirtschaft: Status quo und Ausblick“, 2026. Befragt wurden 603 Unternehmen ab 20 Beschäftigten.